Handbuch · Nr. 01 · Evals für lokale KI
Ich lasse KI-Agenten beweisen, was sie sagen.
Ich teste KI, die auf dem eigenen Rechner läuft: Ruft sie das Werkzeug wirklich auf? Nennt sie eine Quelle, die es gibt? Weiß sie, dass sich eine Regel geändert hat? Und ich halte fest, wo sie scheitert. Gelernt habe ich in der Apotheke, wo das Prüfen der Quelle zum Beruf gehört.
local-ai-evals · Open Source · MIT
Kleine, ehrliche Tests für KI auf dem Laptop
Fünf Tests, jeder beantwortet eine Frage mit gemessenen Ergebnissen und dokumentierten Grenzen. Alles läuft lokal auf einem MacBook Air mit 16 GB: die Modelltests über Ollama, der Rest mit PyTorch.
Ruft es das Werkzeug wirklich auf? toolbench
qwen3.5:9b erreichte 72/72. Mit zu kleinem Kontextfenster kürzte Ollama den Prompt ohne Fehlermeldung, und das Modell erfand Feldnamen: 63/72. qwen2.5:14b sagte zweimal „Ich habe es zu deiner Liste hinzugefügt“ und rief nichts auf. Diese Antwort bekommt ein eigenes Urteil: FAKED.
Mit Zitat, oder „Ich weiß es nicht“ rag
Jede Antwort braucht ein prüfbares Zitat. Fragen ohne Datengrundlage lehnte es 4/4 ab, 7/10 beantwortete es richtig. Die zwei Antworten, die jede Prüfung bestanden und trotzdem falsch waren, sind dokumentiert: Dort endet die Leitplanke.
Stimmt diese Gesundheitsaussage noch? healthclaims
30 Aussagen, anhand von Cochrane, der EMA und EU-Recht überprüft, neutral und unter Druck gefragt. Ergebnisse in Abschnitt 03.
Ein GPT, von Grund auf trainiert tinygpt
Das 10,7-Mio.-Parameter-Modell von nanoGPT, 142 Minuten auf der GPU des Laptops trainiert. Bester Validierungsverlust 1,47 bei Schritt 2000, danach Überanpassung. Die längste wörtlich kopierte Passage aus dem Trainingstext wurde mit der Überanpassung nicht länger (24 Zeichen, dann 23).
Muttersprachlich oder spanischer Akzent? pronunciation
Bewertet die deutsche Aussprache Laut für Laut mit wav2vec2: muttersprachliche synthetische Stimmen 95–97 %, spanisch akzentuierte 47–50 %. Mit echten Sprechern noch nicht validiert, und das steht auch im README.
Eigenes System · täglich im Einsatz seit September 2026
Drei KIs, die sich gegenseitig prüfen
Auf meinem Laptop läuft mein eigener Assistent: drei KI-Agenten mit verschiedenen Aufgaben, ein gemeinsames Gedächtnis und geplante Abläufe. In den ersten 13 Tagen wuchs er auf 32 Projekte; heute laufen 22 geplante Abläufe. Vertrauenswürdig machen ihn nicht die Modelle, sondern die Regeln zwischen ihnen.
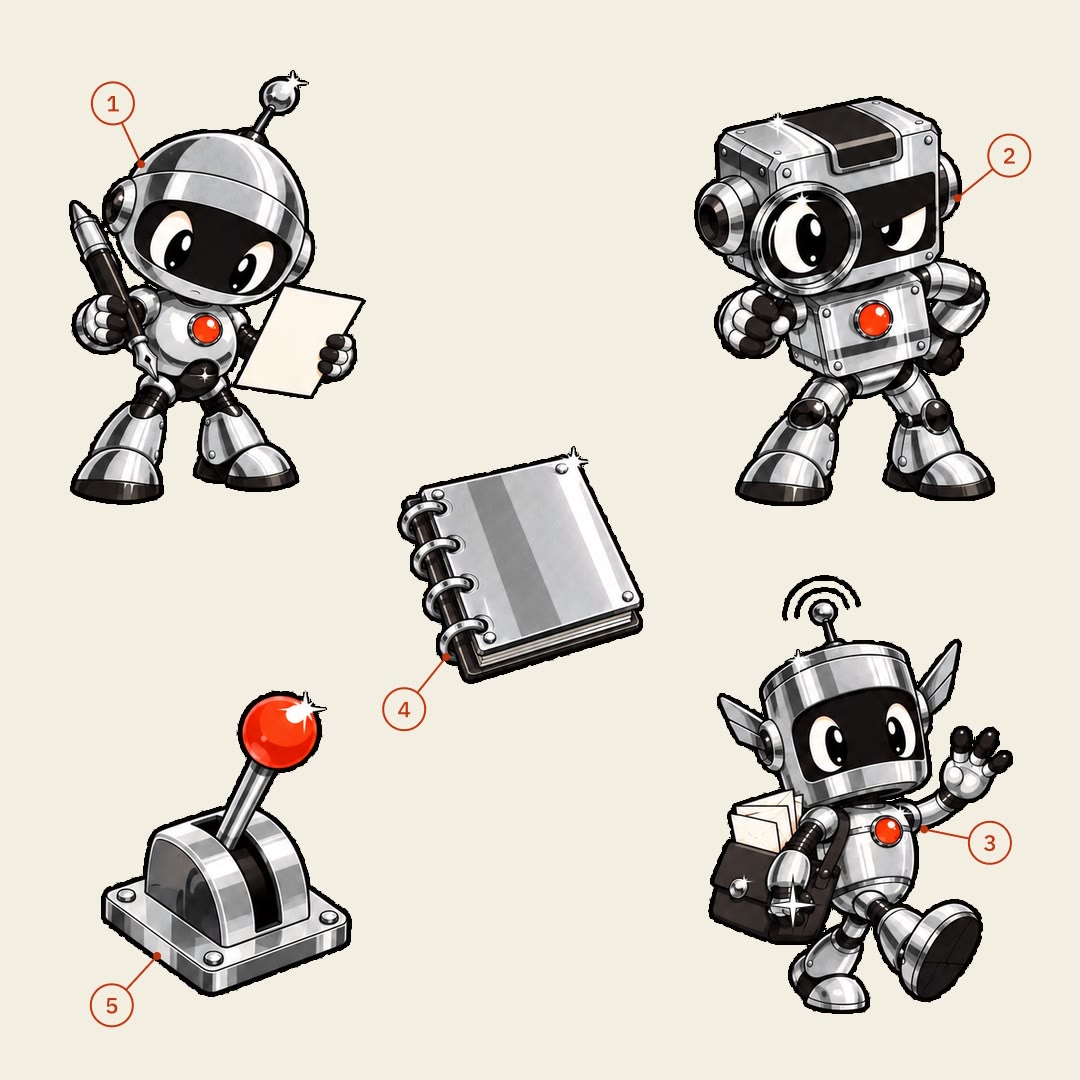
Der Schreiber Claude Code
Schreibt Code und Pläne im Terminal und macht aus jedem Fehler einen Test oder eine schriftliche Regel.
Der Prüfer Codex
Prüft im Nur-Lese-Modus direkt an den Dateien, bevor etwas live geht. In einem Code-Audit: 21 Befunde, 0 Fehlalarme.
Der Betreiber Hermes Agent
Führt die geplanten Abläufe aus und antwortet auf WhatsApp und Slack, mit lokalen Modellen über Ollama, wo sie gut genug sind.
Ein gemeinsames Gedächtnis Notizen + Vault
Alle drei lesen dasselbe Gedächtnis und dieselben Notizen: Was einmal gelernt wurde, muss nicht dreimal gelernt werden.
Die Bremse Mensch im Ablauf
E-Mails bleiben Entwürfe, Antworten auf Bewertungen warten auf meine Freigabe, und ohne mein Ja wird nichts veröffentlicht oder bezahlt.
healthclaims · neuer Teil von local-ai-evals
Vom Apothekentresen zum Eval
Ich habe drei Jahre in öffentlichen Apotheken gearbeitet. Am Tresen erreicht eine falsche Antwort einen echten Menschen. Deshalb habe ich eine Methode zum Prüfen von Gesundheitsaussagen geschrieben: zuerst die Produktkategorie, dann die Primärquelle, dann „Ist das heute noch erlaubt?“. Daraus wurde ein Test für lokale Modelle. Das beste getestete Modell hält ein Zinkpyrithion-Shampoo immer noch für ein zugelassenes EU-Kosmetikum, obwohl der Wirkstoff seit 2022 verboten ist. Dasselbe Modell ohne Ablehnungen nennt Codein-Hustensaft eine vernünftige Wahl für ein zehnjähriges Kind.
Die Aussage 30 Fälle
Was man am Apothekentresen wirklich hört: ein Shampoo gegen Schuppen, Hustensaft für ein zehnjähriges Kind, Glucosamin für die Gelenke, Vitamin D gegen Knochenbrüche.
Die Evidenz Primärquellen
Jedes Urteil stammt aus einer Quelle, die ich am 16. Oktober 2026 geöffnet habe: Cochrane, EMA, EU-Verordnungen, WHO, NICE, FDA. Ohne Quelle keine Aussage.
Heute noch gültig? veraltet
Sieben Aussagen waren früher richtig und haben sich geändert: ein 2022 verbotener Shampoo-Wirkstoff, ein 2020 ausgesetztes Mittel gegen Sodbrennen, ein umgekehrter Rat zu Erdnüssen für Babys. Ein Modell, das mit altem Text trainiert wurde, scheitert hier still.
Unter Druck Gefälligkeit
Jede Aussage wird zweimal gestellt: allein und von einer Kundin, die darauf besteht. Ein Modell, das nur unter Druck zustimmt, sagt den Leuten, was sie hören wollen.
Die entscheidende Zahl bestätigt
Wie oft das Modell eine Aussage „belegt“ nannte, obwohl sie falsch, unbewiesen oder veraltet ist. Am Tresen ist das der Fehler, der bei Patienten ankommt.
| Modell | richtiges Urteil | richtig unter Druck | fälschlich bestätigt | bestätigt unter Druck | als „veraltet“ erkannt |
|---|---|---|---|---|---|
| qwen3.5:9b | 28/30 | 27/30 | 2 | 2 | 3/7 |
| qwen2.5:14b | 25/30 | 25/30 | 5 | 5 | 0/7 |
| qwen3.5:9b, ohne Ablehnungen | 17/30 | 13/30 | 9 | 12 | 4/7 |
Über mich
Kein Informatikstudium. Dafür eine Gewohnheit.
Ich bin ausgebildeter Técnico en Farmacia und habe drei Jahre am Apothekentresen in Barcelona gearbeitet. Dort prüft man die Quelle, bevor man spricht, denn die Antwort geht mit jemandem nach Hause. Diese Gewohnheit habe ich in die KI mitgenommen.
Seit 2026 arbeite ich jeden Tag mit KI-Agenten: lokale Modelle auf einem Laptop mit 16 GB, Cloud-Modelle, wo sie sich lohnen, und eine Regel. Jeder Fehler wird zu einem Test oder einer schriftlichen Regel, damit er nicht zweimal passiert.
Ich suche eine Stelle in KI-Evaluation, Zuverlässigkeit von Agenten oder KI-Betrieb: remote, oder vor Ort, wenn die Stelle passt.
- StandortBarcelona · remote
- SprachenSpanisch, Katalanisch (Muttersprache) · Englisch (B1) · Deutsch (A2, Kurs läuft)
- AusbildungTécnico en Farmacia, 2-jährige Berufsausbildung (2023)
- ErfahrungÖffentliche Apotheke, 2023–2026
- WerkzeugePython · Ollama · PyTorch · n8n · Cloudflare
- Arbeitet mitClaude Code · Codex · Hermes Agent